OpenGL 渲染管线与着色器
从顶点数据进入 GPU,到光栅化、片段着色与深度测试,搭建完整实时渲染心智模型。
OpenGL简介
核心概念
图形渲染管线 Graphics Pipeline
- 顶点数组对象 VAO(vertex Array Object) 记录VBO和EBO组合
- 顶点缓冲对象 VBO (vertex Buffer Object) 记录的是顶点信息
- 元素缓冲对象 EBO (Eelement Buffer Object) / 索引缓冲对象 IBO (Index Buffer Object) 记录的是 顶点的绘制顺序信息
🚅 提示
简单理解: 顶点数组对象会记录顶点缓冲对象以及元素缓冲对象的绑定,解绑等操作,所以先绑定一个VAO,然后再去绑定VBO和EBO等操作,在绘制的时候,只需要换绑不同的VAO,即可绘制不同的顶点(图形)
概念:指的是一堆原始图形数据途经一个输送管道,期间经过各种变化处理最终出现在屏幕的过程
图形渲染管线接受一组3D坐标,然后把它们转变为你屏幕上的有色2D像素输出
opengl的大部分工作是把3D坐标转换成2D像素。3D坐标转换成2D坐标的处理过程使用oopengl的图形渲染管线管理的,图形渲染管线可以划分为2个过程。第一部分把3D坐标转换成2D坐标,第2部分是把2D坐标转变为实际的有颜色的屏幕像素。
gpu能并发执行,所以运算效率高
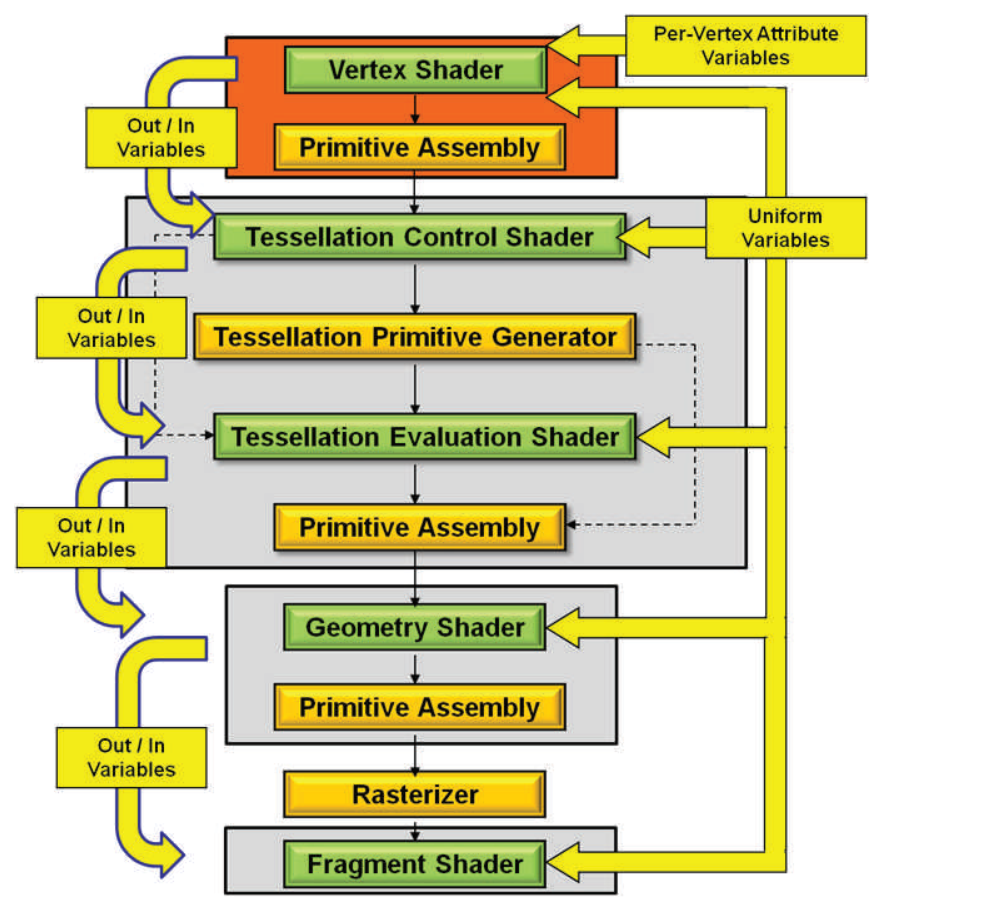
图形渲染管线可以划分为多个阶段,每一个阶段会把前一个阶段的输出作为输入。每个阶段会有一个特定功能的程序来处理,这个程序称为着色器
可自定义的着色器:
顶点着色器vertex shader3D坐标空间变换的作用,输出的是投影空间3D坐标
#必须把位置数据赋值给预定义的gl_Position变量,它在幕后是vec4类型的
#version 330 core
layout (location = 0) in vec3 aPos;

void main(){
    gl_Position = vec4(aPos.x, aPos.y, aPos.z, 1.0);
}
几何着色器geometry shader很少修改 ,使用默认值即可片段着色器(片元)fragment shader
# 片段着色器只需要一个输出变量,这个变量是一个4分量向量,它表示的是最终的输出颜色,
# 我们应该自己将其计算出来。声明输出变量可以使用out关键字,这里我们命名为FragColor
#version 330 core
out vec4 FragColor;

void main(){
    FragColor = vec4(1.0f, 0.5f, 0.2f, 1.0f);
}
小结
📍 提示
总结一下:
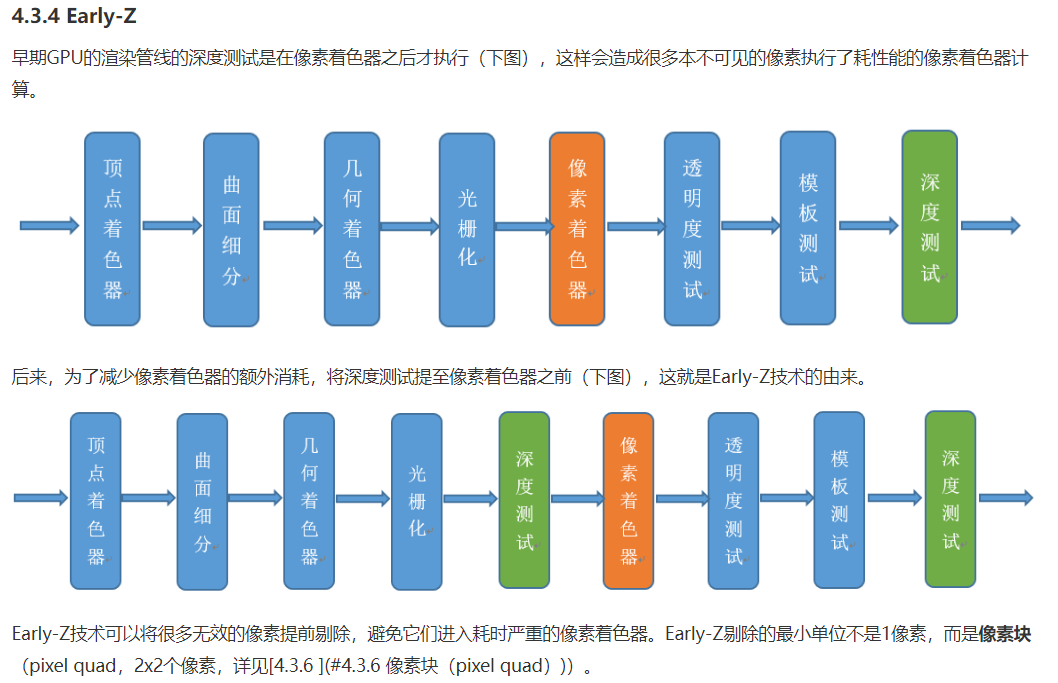
顶点着色器输入后会转换 成投影空间坐标传递给几何着色器,几何着色器会根据类型补充一些顶点,输出到图元装配阶段,图元装配后输出一些形状,然后传入光栅化阶段,映射为最终屏幕像素数据!!以及片段着色器所需要的数据,并且经过裁切后(视野外的会被抛弃,提高效率),传递给片段着色器,计算最终颜色(高级效果,光照、阴影等),然后进入混合阶段,和alpha测试阶段(深度,是否需要丢弃,透明度等),最终输出一个屏幕像素的颜色,显示到屏幕上
标准化设备坐标:(Normalized Device Coordinates)NDC 在(-1,1)之间的坐标,经过顶点着色器处理后的坐标,都应该是DNC (按照投影参数来标准化)
着色器
着色器简介
本章资料 着色器 - LearnOpenGL CN
深入学习资料 The Book of Shaders
**概念定义:**着色器是一个把输入转换为输出的程序,相互之间不能通信,只能通过输入和输出传递数据
特点:
盲视: 相互不能通信
无记忆:一个线程不知道前一刻运行的任务
抽象性
着色器的要素
版本和模式(core),核心模式
输入和输出变量
main函数
着色器的类型 (仅可编程着色器)
顶点着色器
主要负责坐标位置、坐标系统的变换
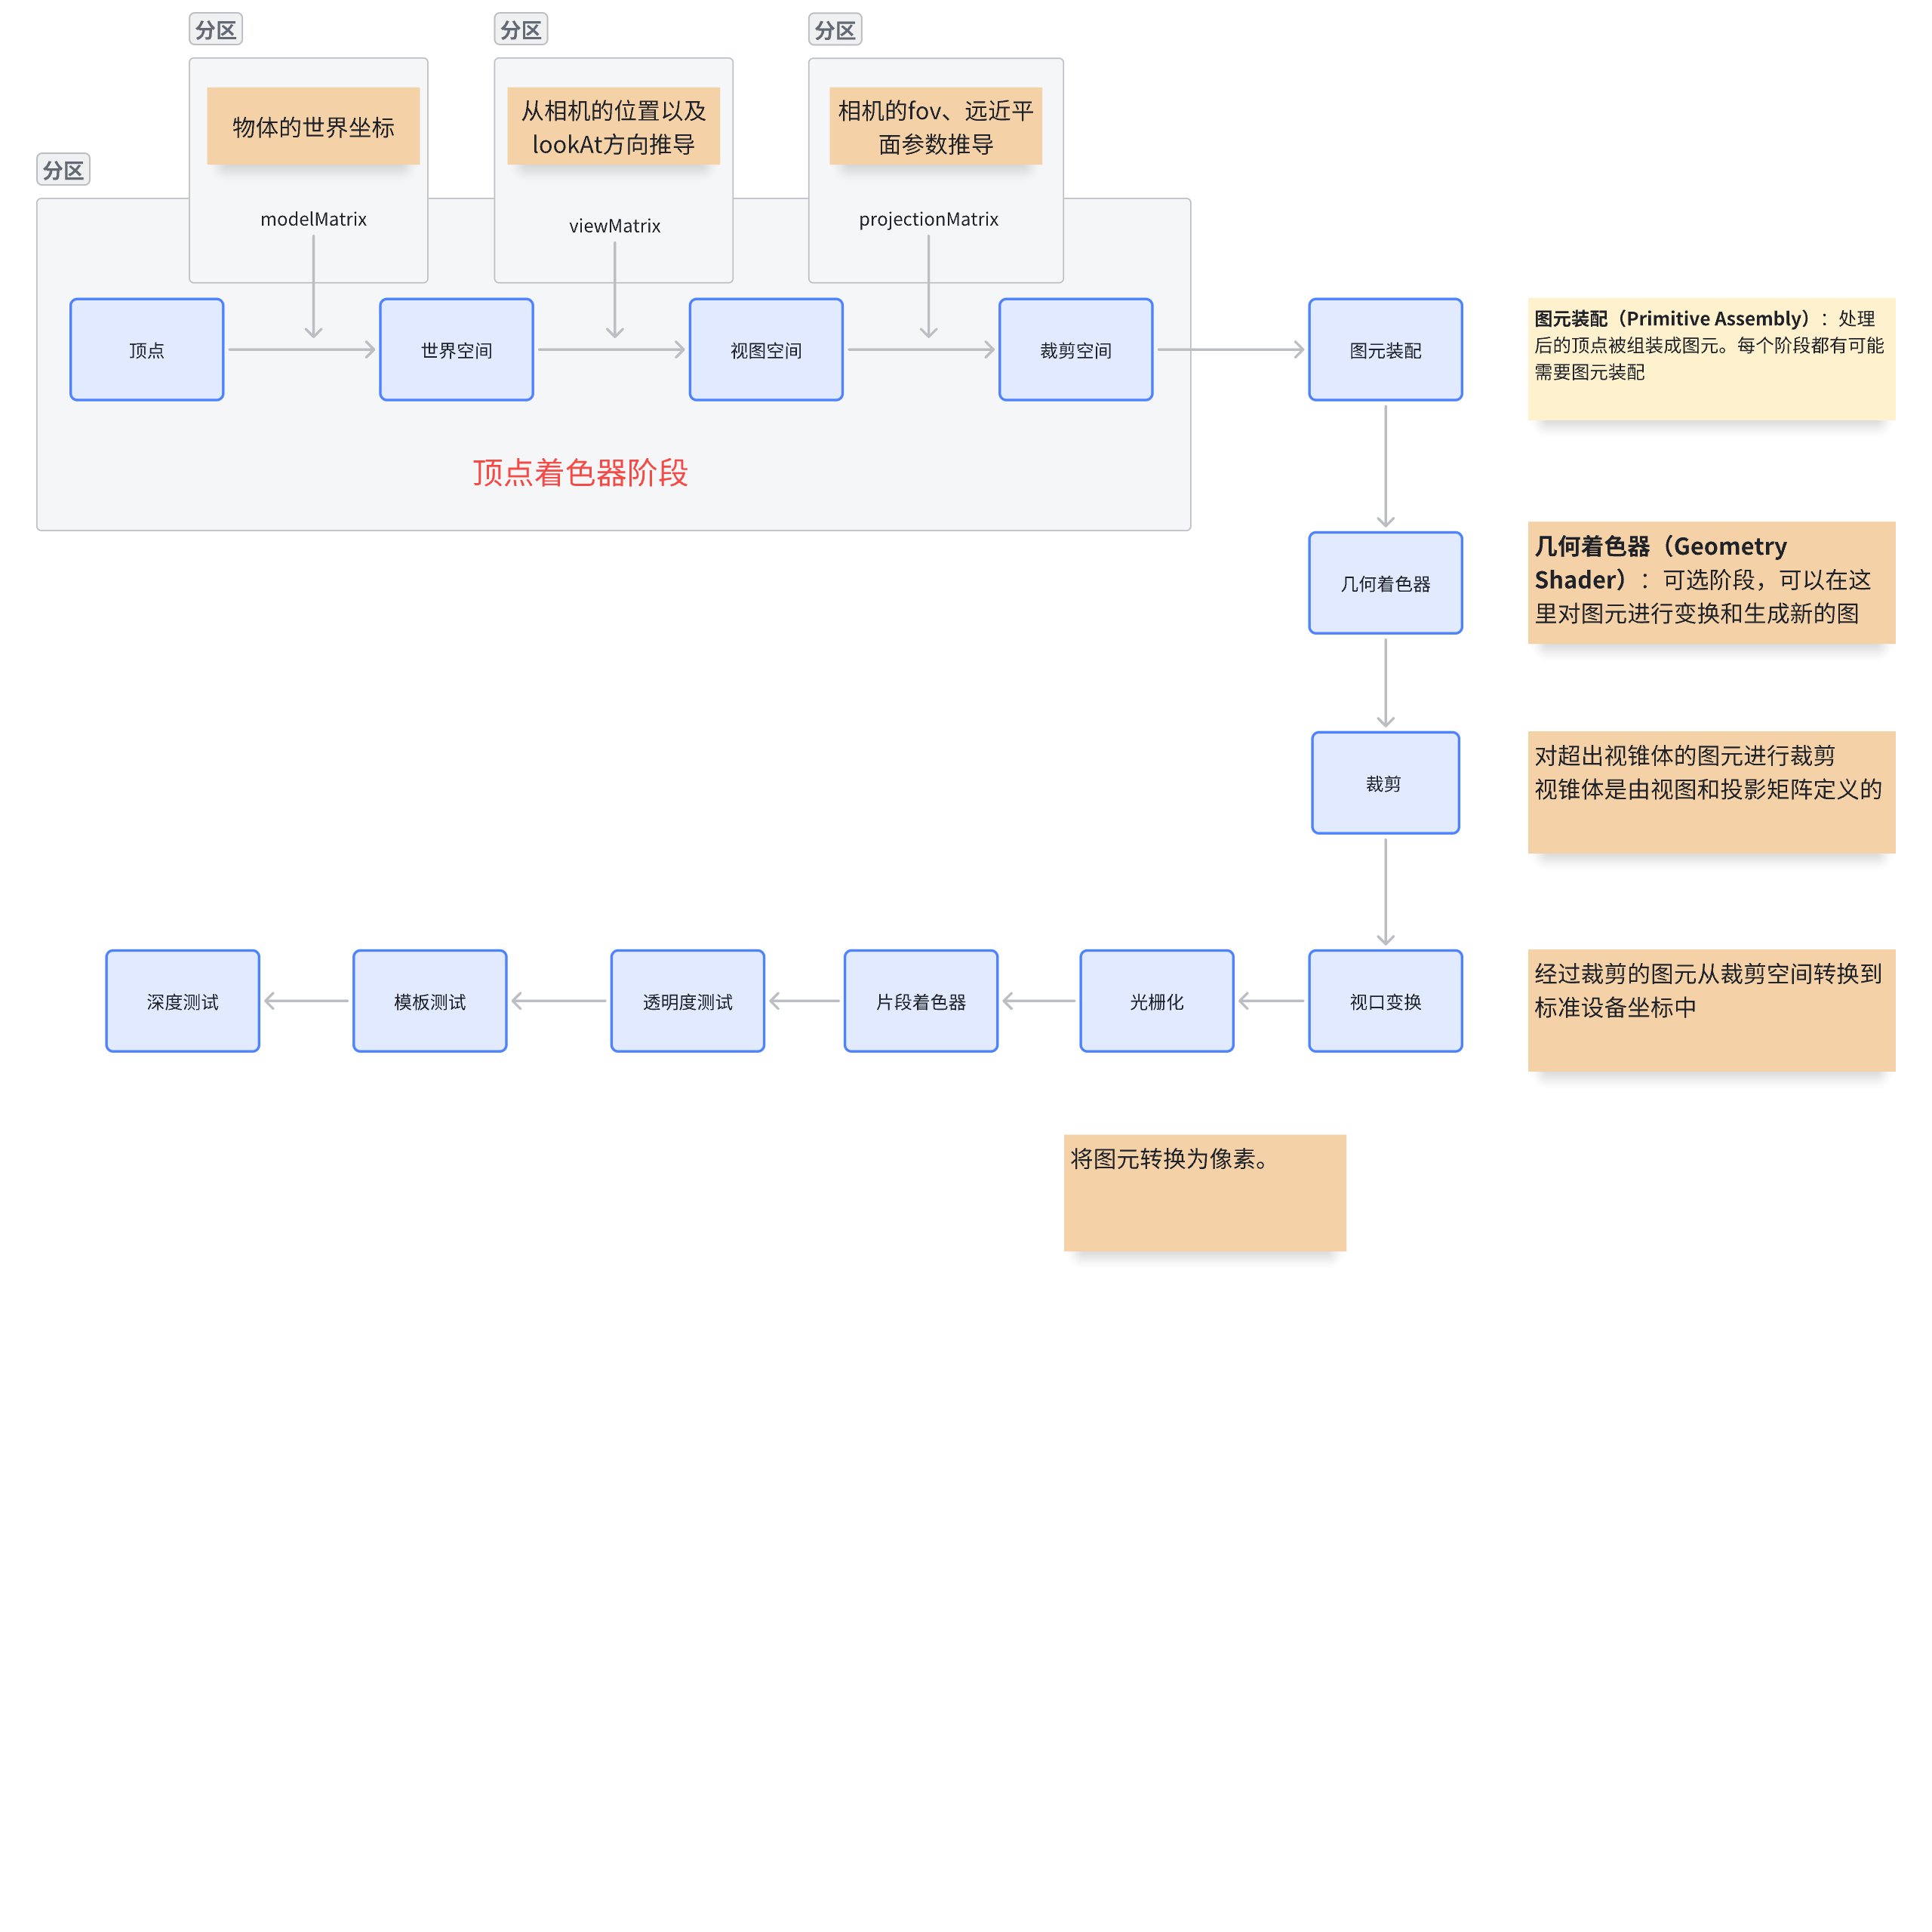
主要从模型的局部坐标经过矩阵转换到世界坐标,再到观察空间,再到裁剪空间,然后裁剪、光栅化,送到片段着色器
🎉 提示
顶点着色器中,与顶点相关的数据通过VBO来传输,那么在threejs中,着色器是与材质挂钩的,如果公用材质,那么uniform也是相同的,不能根据不同的VBO来给mesh传递uniform, 这时一个可行的解决方案是通过一个texture来传递, 如batchedMesh的实现就是通过一个texture来存储不同的模型的matrix,所以,然后不同的模型通过meshid来获取的对应的matrix
片元着色器
主要接收光栅化后每个像素的信息,对像素点的颜色进行计算,包含光照等效果实现
几何着色器
用于改变片元的几何形状,光栅化的具体方式
小结
顶点着色器数量要远远少于片元着色器, 执行计算性能更优,但是效果往往没有在片元着色器中好,因为会有很多像素的是通过插值生成的,片元着色器直接就是每个像素的颜色值
着色器语言 GLSL (opengl shadering language)
in type in_variable_name; //输入变量
out type out_variable_name; //输出变量
uniform type uniform_variable_name //全局变量
- in 输入变量
- out 输出变量->向下一个着色器输出
- uniform 全局变量,着色器程序所有阶段(顶点、几何、片元)均可以访问,在着色器中不可修改,但可以在CPU中被更新
- 向量
- vecn 包含n个float分量的默认向量
- bvecn 包含n个bool分量的向量
- ivecn 包含n个int分量的向量
- uvecn 包含n个unsigned int分量的向量
- dvecn 包含n个double分量的向量
// 重组(Swizzling)
vec2 someVec;
vec4 differentVec = someVec.xyxx;
vec3 anotherVec = differentVec.zyw;
vec4 otherVec = someVec.xxxx + anotherVec.yxzy;

vec2 vect = vec2(0.5, 0.7);
vec4 result = vec4(vect, 0.0, 0.0);
vec4 otherResult = vec4(result.xyz, 1.0);
纹理
本章资料 learnopengl-纹理
基础介绍
纹理坐标映射
纹理图片的坐标是(0,0)到(1,1),映射到顶点定义的坐标上去
需要指定三角形的每个顶点各自对应纹理的哪个部分。这样每个顶点就会关联着一个纹理坐标(Texture Coordinate),用来标明该从纹理图像的哪个部分采样。之后在图形的其它片段上进行片段插值(Fragment Interpolation)
纹理的环绕方式
当纹理坐标超出默认范围时,OpenGL的行为方式
❗ 提示
【超出默认范围】的理解 在顶点数据中,我们如果设置了纹理坐标(uv坐标),它的范围一般是0~1,但是如果配置了一个uv坐标的值(1.5,2),这个时候采样就超出了纹理的默认范围(0,1),这个情况下的重复方式,就是纹理的环绕方式
嵌入表格
| 环绕方式 | 描述 |
|---|---|
| GL_REPEAT | 对纹理的默认行为。重复纹理图像。 |
| GL_MIRRORED_REPEAT | 和GL_REPEAT一样,但每次重复图片是镜像放置的。 |
| GL_CLAMP_TO_EDGE | 纹理坐标会被约束在0到1之间,超出的部分会重复纹理坐标的边缘,产生一种边缘被拉伸的效果。 |
| GL_CLAMP_TO_BORDER | 超出的坐标为用户指定的边缘颜色。 |
纹理过滤 (纹理的采样方法)
线性过滤 GL_NEAREST(Nearest Neighbor Filtering)
❗ 提示
官方解释: 它会基于纹理坐标附近的纹理像素,计算出一个插值,近似出这些纹理像素之间的颜色。 一个纹理像素的中心距离纹理坐标越近,那么这个纹理像素的颜色对最终的样本颜色的贡献越大
我的理解: 线性计算纹理像素点最终的颜色(按距离比例计算采样坐标周围4个像素点的颜色,计算出一个最终结果)更圆滑
邻近过滤 GL_NEAREST(Nearest Neighbor Filtering)
我的理解:采样坐标点离哪个像素最近,就返回哪个像素的颜色,锯齿感更强
多级渐远纹理
什么是多级渐远纹理?
为什么需要多级渐远纹理?
❗ 提示
- 纹理的分辨率是固定的
- 远的物体和近处的物体的顶点数量是相同的,但是渲染出来的像素点数量是不一样的(小的物体像素点少,片元少)
- 如果使用相同的纹理采样就是导致一个远处物体的像素点对应到纹理的一大片像素点,拾取的颜色失真会十分严重
- 多级渐远纹理就是把纹理根据远近的级别,对纹理进行变换
纹理单元
可以给片元着色器设置多个纹理,默认是0 至少有16个可以的纹理单元(0-15)
变换
向量
🏆 提示
向量是有方向有大小的量,两个特征,有大小 有方向,表示的是一个空间的方向
向量的长度
向量的运算
向量与标量(常量)运算
- 加减乘除 向量每个分量和标量分别计算,得到新的向量
📍 提示
减和除都只能向量-/标量, 标量-/向量没有意义 个人理解的原因:常量是一维的,而向量是多维的,多维可以在每个维度上运算,即多维可以降维,单维无法升维
- 向量取反 乘-1即可
向量之间的运算
- 加减法
对应的分量加减即可
🏆 提示
加法表示的几何意义是两个向量平移后首尾相连,起点到终点的连线 减法表示的几何意义是被减数的向量指向减数向量的连线
- 向量的乘法
- 点乘
定义:点乘等于它们的数乘结果(两个向量长度相乘)乘以两个向量之间夹角的余弦值
v⋅k=||v||⋅||k||⋅cosθ
🎉 提示
如果两个都是单位向量,则点乘的结果就是两个向量之间夹角的cos值,cos0是1,cos90是0,由此可以判断向量是否平行或相交
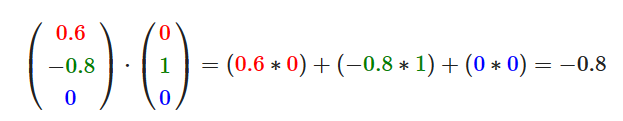
应用:单位向量的点乘可以用来计算两个向量之间的角度,从而判断垂直:
每个分量相乘结果相加,再通过反余弦函数即可求出角度,如果不是单位向量,可以先标准化,再去计算!!
13651734032
- 叉乘
🥛 提示
需要两个不平行向量作为输入,生成一个正交于两个输入向量的第三个向量,如果输入的两个向量也是正交的,那么叉乘之后将会产生3个互相正交的向量
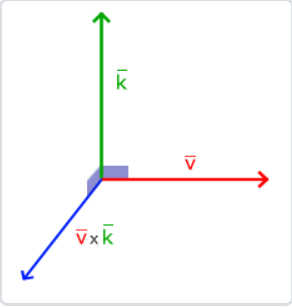
计算
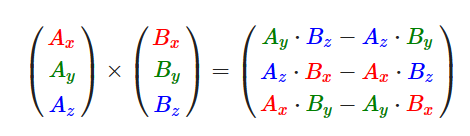
矩阵
🥖 提示
定义:一个矩形的数字符号表达式 (i行j列),所谓的行列式
矩阵的加减:
🎉 提示
和向量同样的道理,只能矩阵加减标量,或者维度相同的矩阵,才是有意义的
矩阵的数乘
❤️ 提示
每个元素的与标量相乘得到新的矩阵,这个标量就相当于一个放大因子
矩阵的乘法
两个限制
只有当左侧矩阵的列数与右侧矩阵的行数相等,两个矩阵才能相乘。
🎼 提示
因为乘法的法则是拿左侧矩阵的第n行的每个数分别乘以右侧矩阵的第m列,结果相加,得到坐标为(n,m)的结果 所以:左侧矩阵的每一行的元素个数(列数),需要与右侧矩阵的每一列的元素数量(行数)相等,也就是左侧矩阵的列数需要与右侧矩阵的行数相等,两个矩阵才能相乘
矩阵相乘不遵守交换律(Commutative),也就是不能交换位置
✍️ 提示
也就是左乘和右乘的结果不同
但是,矩阵遵守乘法结合律,所以可以通过一个矩阵的逆矩阵来求出变换矩阵
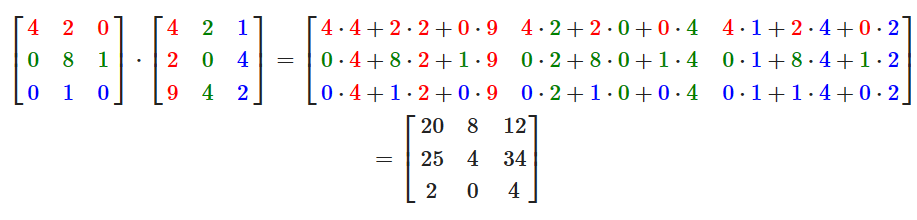
矩阵与向量相乘
🍰 提示
向量可以看成N维的矩阵(只有一列) Nx1的矩阵
所以可以和一个MxN的矩阵相乘
单位矩阵: 对角线是1,其他值是0的矩阵
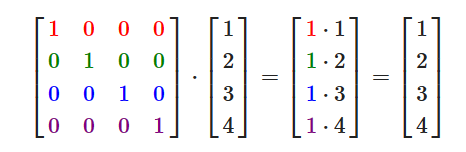
矩阵的作用
threejs中的matrix是一个列秩的数组,索引0,5,10的值是x,y,z的缩放因子
缩放
🎁 提示
对角线的值就是缩放的分量,
- 均匀缩放 每个缩放的分量相等
- 不均匀缩放,分量不相等
位移
threejs中的matrix是一个列秩的数组,索引12,13,14的值是x,y,z的位移值
📍 提示
单位矩阵中,使用齐次坐标实现位移,在第4个分量(w)上,书写需要位移的分量,通过矩阵相乘即可
旋转 略复杂,使用四元数
矩阵的组合
矩阵变换的力量是可以把多个变换组合到一个矩阵中
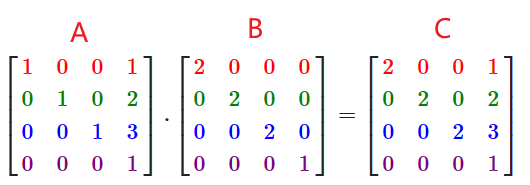
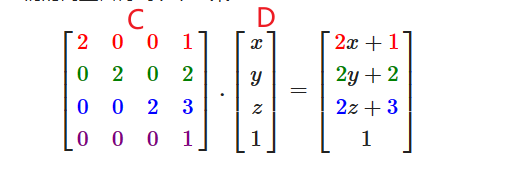
- 注意1:矩阵的乘法不遵守乘法交换律
所以这里矩阵A * B 得到的结果与向量D相乘,即 A * B *D 由于B离矩阵D最近,所以实际的变换顺序是 先应用了矩阵B,然后才是矩阵A
亦即:
矩阵左乘向量,因为向量总是在最后,所以越在后面的矩阵,越早进行变换
- 注意2:
缩放的顺序很重要,先缩放再位移和先位移再缩放得到的结果不一样!!
在组合矩阵时,先进行缩放操作,然后是旋转,最后才是位移,否则它们会(消极地)互相影响。比如,如果你先位移再缩放,位移的向量也会同样被缩放
坐标系统
实际上,每经过一个矩阵变换,就已经是进入另一个坐标系统了
坐标类型
物体坐标 又称局部坐标 (local coordinate or object coordinate)
🚅 提示
每个物体建模的时候都有自己的坐标系
世界坐标 (world coordinate)
🎨 提示
3D世界的坐标,其他的模型都按照这个坐标的位置放置,是经过model-matrix转换得到
投影坐标 视图坐标 观察坐标 view coordinate /eye coordinate
🎼 提示
投影就是把坐标转换到相对于观察者的视角下的坐标,也就是以观察者为坐标原点的坐标,经过观察矩阵得到
view-matrix
观察矩阵把所有的世界坐标变换为相对于摄像机位置与方向的观察坐标
裁剪坐标 clip coordinate
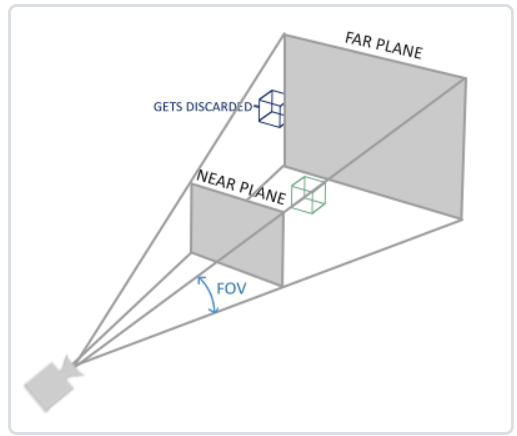
projection-matrix 远近平面-fov 以及对z的非线性转换
🎁 提示
把特定的坐标转换成标准设备坐标的过程,舍弃标准设备坐标范围外的坐标,经过投影矩阵(projection matrix)得到, 投影矩阵与相机的平截头体的参数定义相关,由这些参数计算得来,用来计算深度缓冲的变换 平截头体用来获取z轴的范围,以及xy的范围 这个投影矩阵其实还包含了对z值的精度非线性调整 这给了近处的物体很大的深度精度。这个(从观察者的视角)变换z值的方程是嵌入在投影矩阵中的,所以当我们想将一个顶点坐标从观察空间至裁剪空间的时候这个非线性方程就被应用了
这个矩阵后得到的仍然是观察空间的坐标得到的已经是裁剪空间了,因为虽然视角上仍然是观察空间的,但是坐标的值已经发生变换
屏幕坐标 screen coordiate
🎨 提示
经过viewport transform 最后变换出来的坐标将会送到光栅器,将其转化为片段,提供给下一阶段使用(片段着色器),最后得到屏幕像素(和屏幕坐标有区别,屏幕坐标不一定是整数)
几个坐标的关系概述
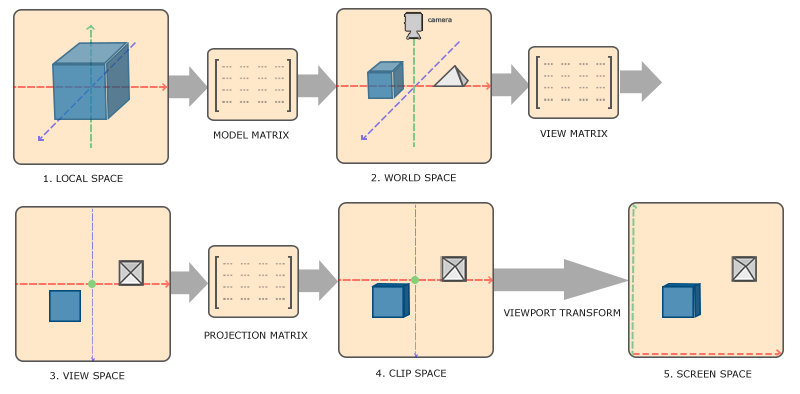
以上1 -4步发生在顶点着色器中,顶点着色器输出的是经过投影矩阵计算得到的裁剪空间的顶点坐标,被赋值到顶点着色器中的gl_Position ,然后进入下一阶段的管线,OpenGL将会自动进行透视除法和裁剪(根据相机定义的远近平面和fov),经过视口变换后,最后才会传递到片元着色器,片段着色器后才是混合与深度测试(也有提前深度测试,发生在片段着色器之前)
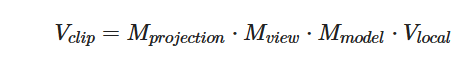
OpenGL然后对裁剪坐标执行透视除法从而将它们变换到**标准化设备坐标,**然后用glViewPort内部的参数来将标准化设备坐标映射到屏幕坐标
透视除法: 顶点着色器之后,OpenGL会自动执行的一步,将xyz向量分别除以齐次向量w,
裁剪空间中坐标,只是计算了值,并没有进行裁剪,裁剪发生再透视除法之后,超出范围的值会被丢弃
这里具体过程下次复习时,需要结合 【十、高级OpenGL】中关于深度的知识
- 总结关于渲染管线的,所知道的概念的一个执行流程
左右手坐标系
Threejs使用右手坐标系
右手坐标系
👍 提示
- 沿着正y轴方向伸出你的右臂,手指着上方。
- 大拇指指向右方。
- 食指指向上方。
- 中指向下弯曲90度。
左手坐标系
👍 提示
- 沿着正y轴方向伸出你的左臂,手指着上方。
- 大拇指指向右方。
- 食指指向上方。
- 中指向下弯曲90度。
🥛 提示
左右手坐标系的区别:z轴的方向相反
深度测试
深度缓冲 z-buffer 储存所有的深度信息。更详细的描述查看【十、高级OpenGL/深度测试】
🎨 提示
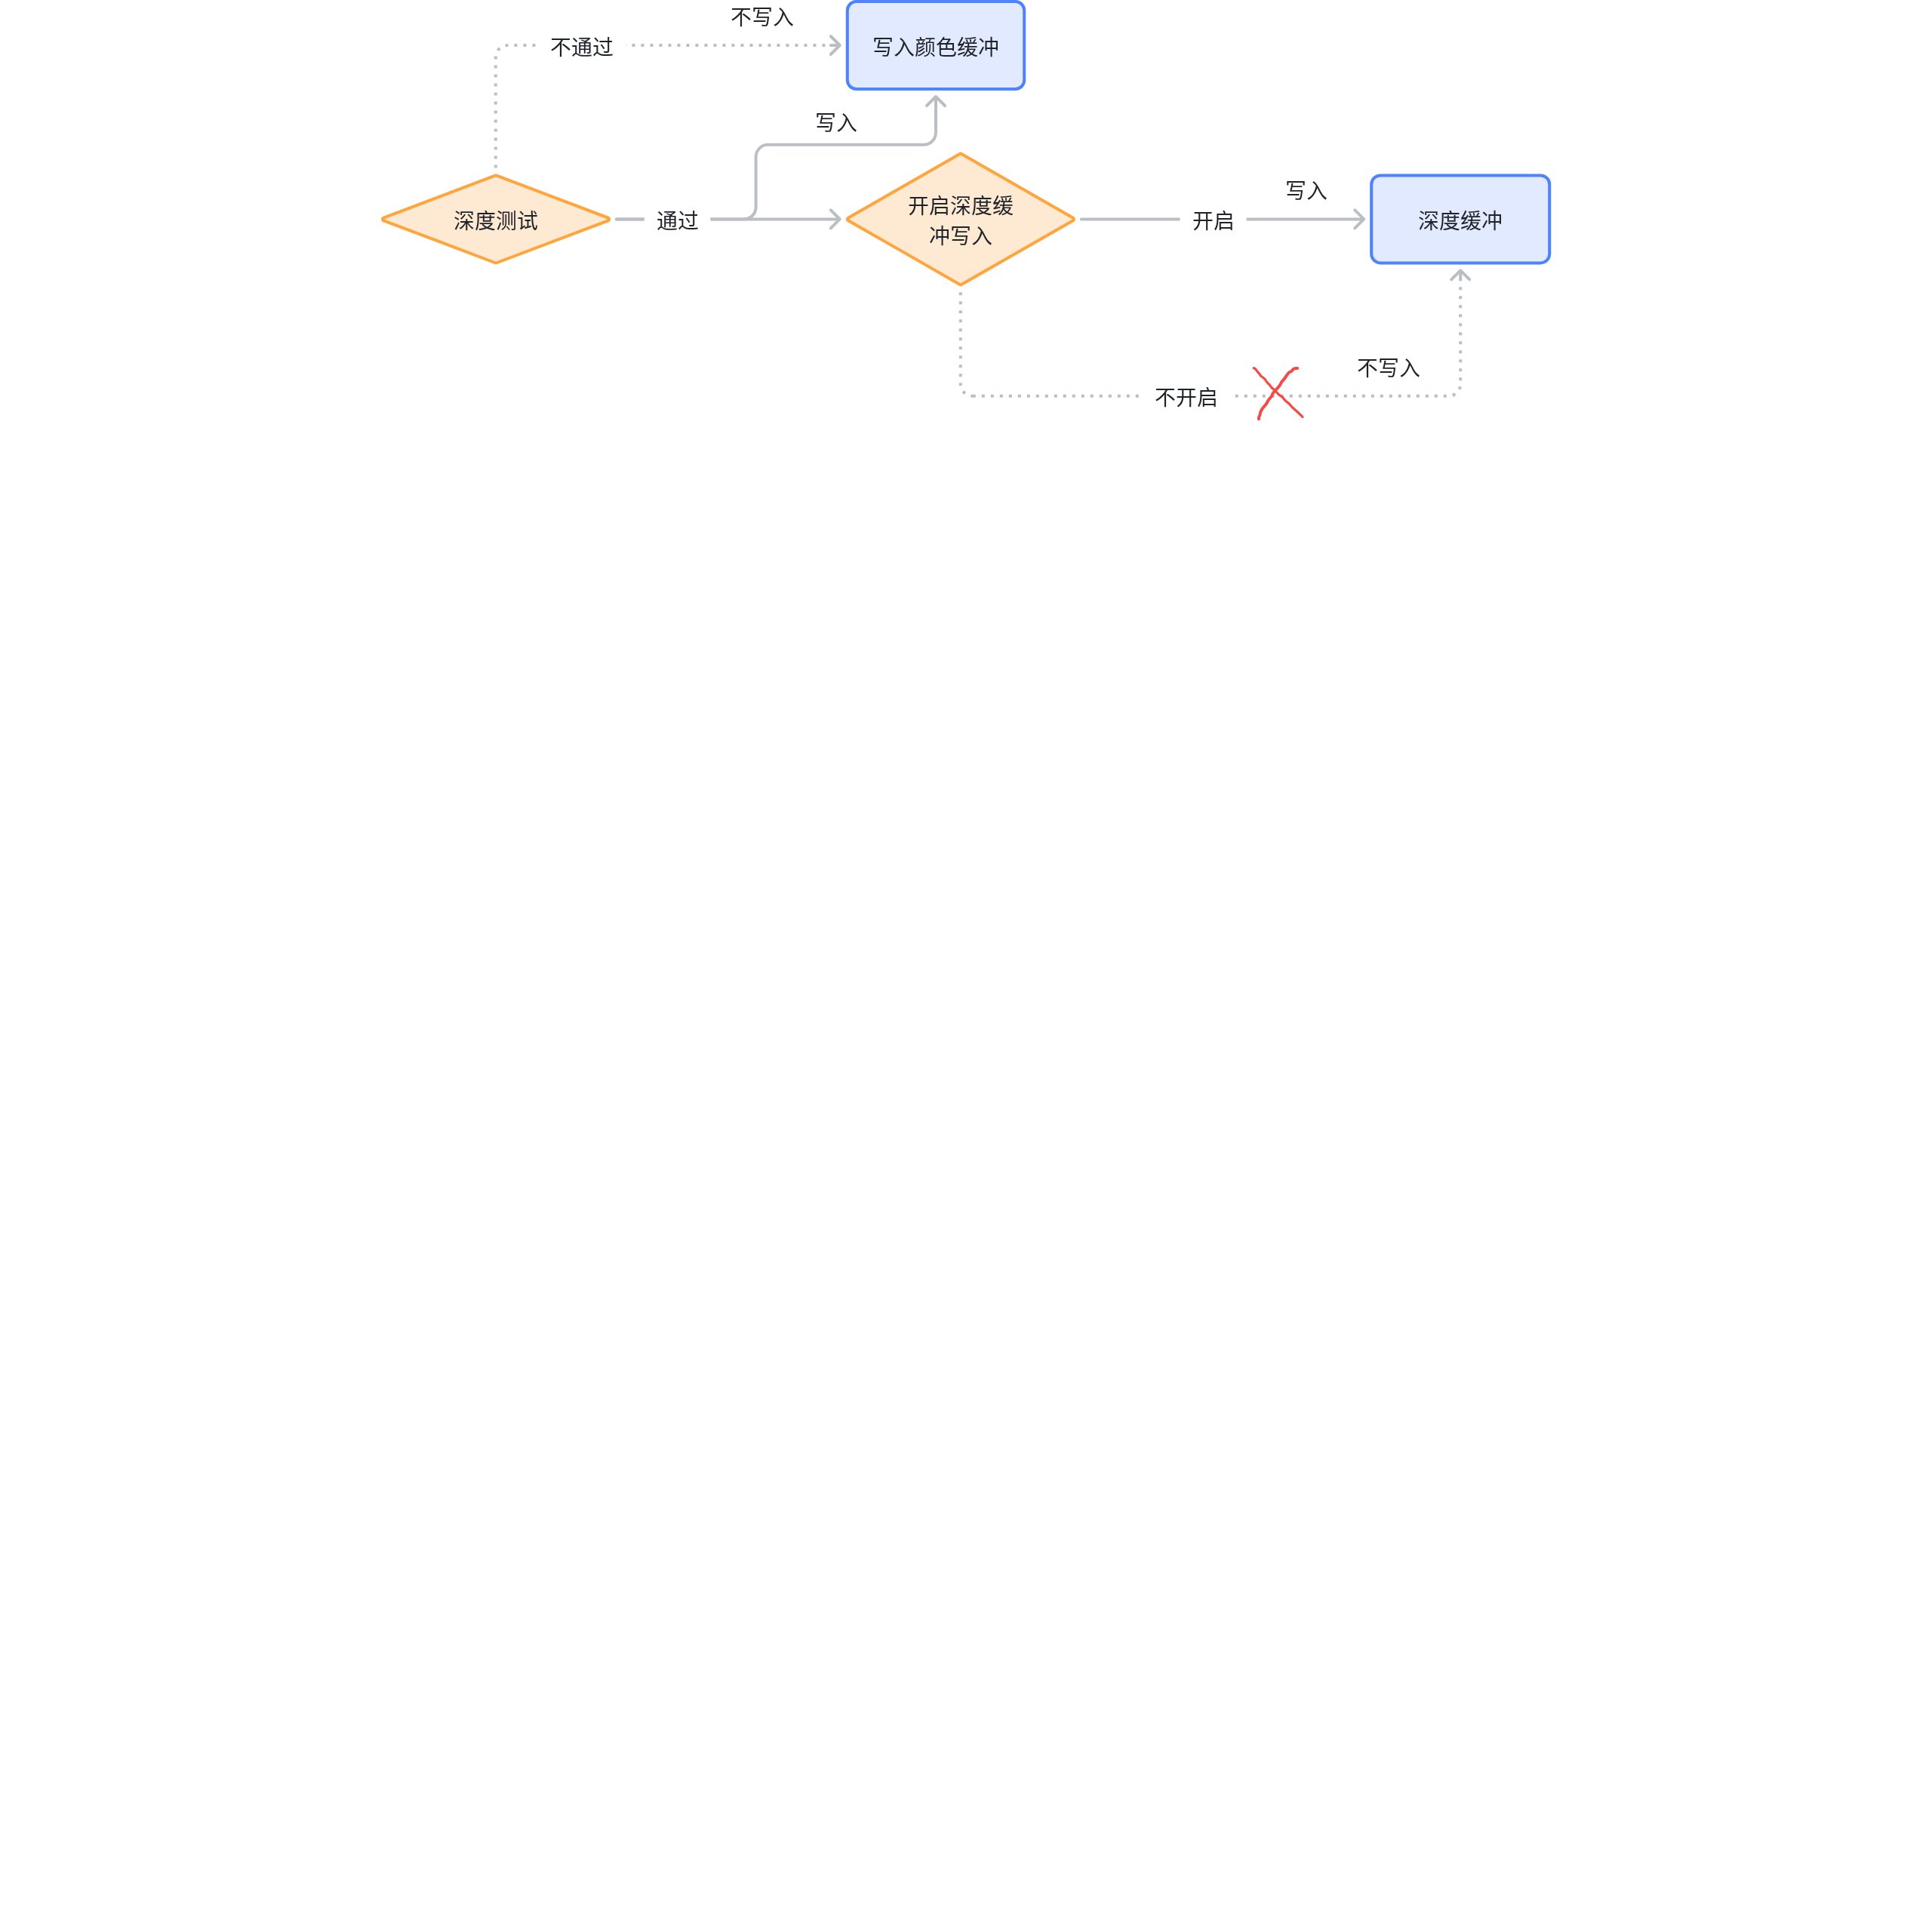
输出时将每个片段的深度信息和z-buffer对比,如果片段在后面,z值会被抛弃,这个过程被称为深度测试 深度测试只是测试深度值,从而决定是否去更新颜色缓冲中的值 渲染的过程中有几个重要的步骤需要明确,深度测试、深度缓冲写入、颜色缓冲写入 【深度测试】如果开启了,只有通过
深度测试的片段的颜色才能写入颜色缓冲中,没有开启,则每次都会写入颜色缓冲【深度缓冲写入】把当前片段的**深度值,更新到深度缓冲中去,不开启时,即使深度测试通过了,也不更新 【颜色缓冲写入】不开启深度测试,或者深度测试通过的情况下会把片段颜色写入到颜色缓冲**中,(不开启深度缓冲写入也不影响颜色缓冲写入)
摄像机
📌 提示
所谓摄像机,不过一个矩阵而已,所有的变换,不过都是变换这个矩阵,根本没有相机
观察空间
讨论摄像机/观察空间(Camera/View Space)的时候,是在讨论以摄像机的视角作为场景原点时场景中所有的顶点坐标:观察矩阵把所有的世界坐标变换为相对于摄像机位置与方向的观察坐标
- 观察矩阵 把世界坐标变换成相对于摄像机位置与方向的观察坐标
view Matrix
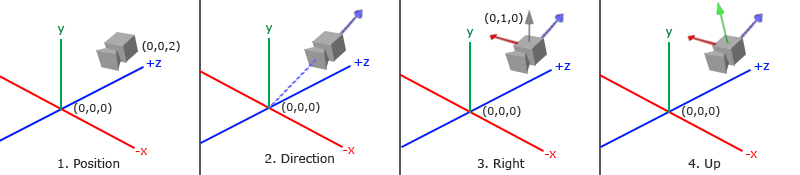
相机矩阵推导:
前提条件:
- 相机的位置 (0,0,3)
- 相机的方向 (0,0,0)
- 一个世界坐标的向上方向 (0,1,0)
- 移动 改变观察矩阵来实现
鼠标的移动输入由鼠标的前后变化位置计算各个向量分量,最后应用于观察矩阵的变化
lookAt矩阵
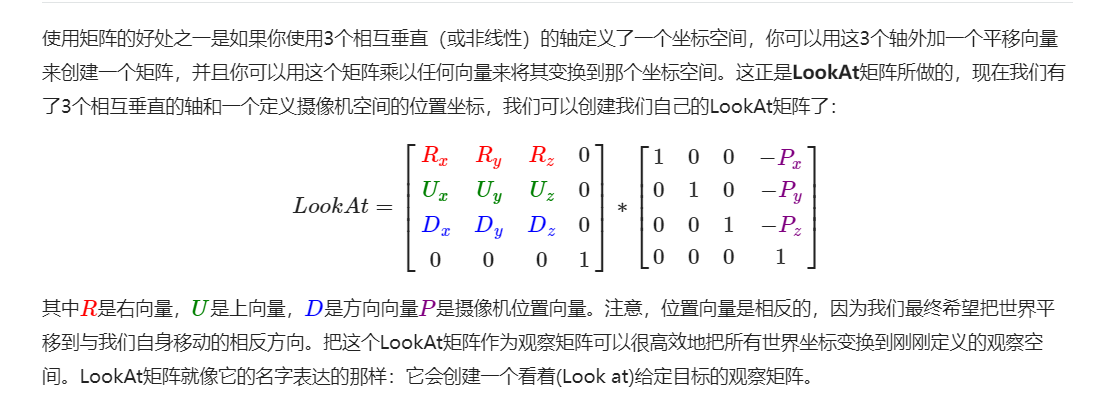
💡 提示
在计算机图形学中,"lookAt"矩阵和"view"矩阵都用于定义摄像机的位置和方向,但它们在实现方式上有所不同。
lookAt矩阵:这个矩阵用于将世界坐标系中的点转换到摄像机坐标系中。它通常由三个参数来定义:摄像机的位置(eye),目标点(look-at point),以及一个向上向量(up vector)。lookAt矩阵可以通过以下步骤来计算:
- 首先计算从摄像机位置到目标点的Z轴(forward vector)。
- 然后计算X轴,通常使用向上向量和Z轴的叉乘来得到。
- 接着计算Y轴,使用Z轴和X轴的叉乘。
- 最后,将这些向量归一化,并构造出一个旋转矩阵。
- 将摄像机平移至目标点的相反方向,以完成lookAt矩阵。
view矩阵:也称为摄像机矩阵或观察矩阵,它通常是指将世界坐标系中的点转换到摄像机坐标系中的矩阵。在某些上下文中,"view"矩阵可能与"lookAt"矩阵相同,但在其他情况下,"view"矩阵可能包括更广泛的摄像机设置,如视野(field of view)、纵横比(aspect ratio)和近远裁剪平面(near and far clipping planes)。 总的来说,lookAt矩阵是创建view矩阵的一种特定方法,它专注于摄像机的位置和朝向。在某些实现中,这两个术语可能会互换使用,但在更严格的计算机图形学定义中,view矩阵可能包含lookAt矩阵以外的其他摄像机参数。 来自kimi
📌 提示
你所认识的世界,都是对世界的抽象,有时候很难分清抽象与事物本身的关系
- 查看threejs中源码的viewMatrix和projectionMatrix是如何计算的
光照
颜色
定义
⚽ 提示
物体的颜色是由物体反射出来的光决定的,也就是物体不吸收的部分颜色,才是物体的颜色,或者说被认为是物体的颜色
可以使用光照颜色和物体对颜色的吸收特性,来模拟物体的颜色特性
图形学中,物体颜色的定义:物体从一个光源反射各个颜色分量的大小。也就是这个反射分量,就代表了物体的颜色的意义,表示如果光源是白光的话,物体看起来的颜色;其它颜色的光源,则表现不相同
光照
所谓的亮和暗,都是通过物体显示的颜色变化来表现的,所谓的光,不过是一个显示颜色的数值比例,根本没有光
总结: 不同的物体在不同的光下有不同的颜色表现(正确的废话)
含义如下:
- 为了实现不同的光的模拟,使用冯氏光照模型来近似描述光 -> 光照的三个分量,既可以认为是颜色值,也可以认为是对白色光的反射率
- 为了模拟不同物体对光的反应,同样需要对物体的材质使用冯氏模型来进行细粒度的描述 -> 光照贴图
- 通过在片元着色器中,光的三个分量与物体的三个分量分别计算后叠加,得到最终的颜色
- 光照模型就是在光源和物体两个方面都细粒度描述光照的效果
现实世界的光照是极其复杂的,计算机图形只能使用一些简化的模型来近似模拟,其中冯氏光照模型最常用
冯氏光照模型包含三个分量:
- 环境光照 Ambient Light 各个方向的微弱光线,通常来自不同的物体,设置一个常量模拟
- 漫反射光照 Diffuse Lighting 冯氏光照视觉上最显著分量 模拟光照对物体方向性影响
- 镜面光照 Specular Lighting 有光泽物体上的亮点,镜面光照的颜色相比物体颜色更倾向于光线颜色
漫反射和镜面反射的一个重要的区别在于,漫反射和观察角度无关,而镜面反射和观察角度相关,要计算物体是否在光线照射的半径内
冯氏光照模型光照分类
❗ 提示
在世界空间中计算光照的原因:光源是需要在世界空间中才好去计算光照的方向,同时面的法向量也要转换到世界矩阵中,计算出的结果可以传递给片元着色器去计算最终的颜色,更常见的是在观察空间中计算, 在哪个空间中计算都不影响结果
环境光照
真正去实现模拟环境光源开销巨大且价值不大,所以不使用这个方式,而是使用光的颜色乘以一个很小的环境因子再乘以物体的颜色来模拟
这样只需要在片元着色器中进行一次计算,即可达到效果,性能好!
片元着色器的数量比顶点着色器多得多!!
漫反射光照
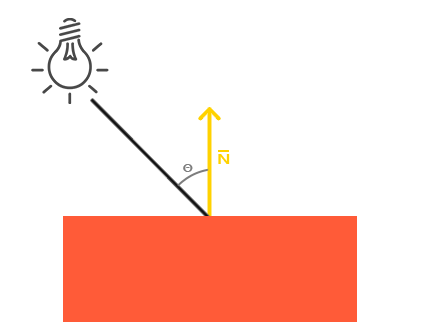
光照的计算过程
需要的条件: 光线的方向、法向量
漫反射一般为固定方向的光线对物体的影响,所以光线与面的相交角度对亮度的影响很大,可以通过法向量得到
- 定义一个光源位置,方便后面和顶点一起计算出光线方向,定义光源颜色
- 将顶点转换成世界坐标,并计算顶点所在的面的法向量(亦即在世界空间中去计算漫反射,为啥?)
- 和光源一起计算光线向量,从而计算漫反射分量,(注意负数颜色无意义,最小取0),注意标准化,使用单位向量
- 计算漫反射值和其他光照的值,乘以物体颜色
- 漫反射分量与物体颜色相乘得到最终颜色
镜面光照
镜面光照计算需要一个额外的观察向量,不同的角度观察,镜面反射的光照强度不同
原理是计算反射角与观察向量的夹角来分配不同的光照强度
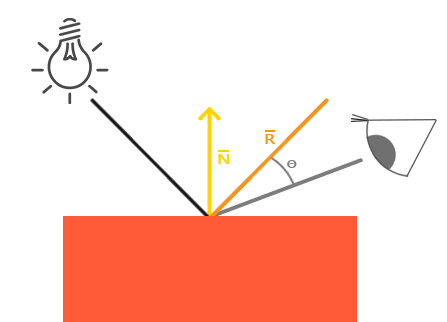
反光度(Shininess): 反光度越高,反射光的能力越强,散射得越少,高光点就会越小
🎹 提示
在光照着色器的早期,开发者曾经在顶点着色器中实现冯氏光照模型。在顶点着色器中做光照的优势是,相比片段来说,顶点要少得多,因此会更高效,所以(开销大的)光照计算频率会更低。然而,顶点着色器中的最终颜色值是仅仅只是那个顶点的颜色值,片段的颜色值是由插值光照颜色所得来的。结果就是这种光照看起来不会非常真实,除非使用了大量顶点
一般情况下,顶点着色器中的计算次数比片段着色器中少得多(至少至少相等),因为片段着色器是由顶点着色器扩充而来的,包含了所有的像素,而顶点只包含了顶点而已
法线向量
垂直于片元表面的向量
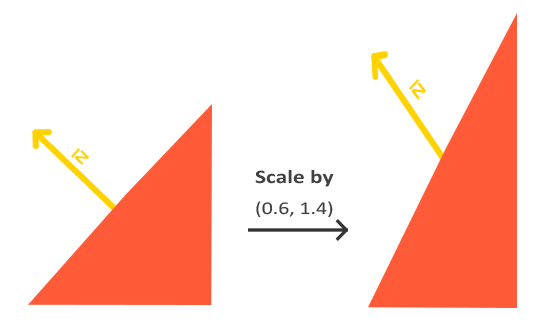
法线矩阵
为了消除不等比缩放等操作对法线的影响(导致法线向量不再垂直于片元表面)的特殊矩阵,作用于法线向量相同
具体的矩阵推导看原文
材质
概念
我理解的材质是什么?
材质就是物体的反光属性,对环境光、漫反射、镜面反射的各种颜色反射的程度,在冯氏光照模型中就是rgb的分量
设置物体的材质以及光照的颜色
在opengl中的材质包括 环境光(ambient)、漫反射(diffuse)、镜面反射(specular) 反光度(Shininess)
由于环境光、漫反射、镜面反射的强度不同,所以需要在光源中去定义各个反射的强度
光照贴图 本质上就是纹理, 也就是说,这个计算本质上就是在贴图颜色的基础上混合光的颜色
- 漫反射贴图 本质上就是纹理图片的颜色,也就是说,这个计算本质上就是在贴图颜色的基础上混合光的颜色
- 镜面反射贴图 原理和上面相同,只是贴图像素信息只表示镜面光的强度
投光物
定向光
距离很远的光源,可以认为是平行光,所有的方向都一致,无需计算衰减,所以物体与光源的相对位置是不重要的
点光源(point light)
- 有位置,需要计算光的方向
- 有衰减 ,按距离衰减 线性或者非线性
- 朝所有方向照射
聚光(spot light)
- 有照射范围,需要根据切光角计算范围
- 有位置,需要计算光的方向
- 有衰减
- 只照射特定方向
衰减(Attenuation) 随着光线传播距离的增长逐渐削减光的强度通常叫做衰减,一般不是线性衰减,而是一个二项式
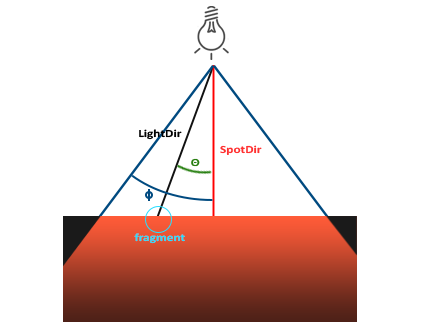
聚光的计算,光源的位置,角度计算出片元是否在聚光内,在则计算片元的颜色与光颜色的混合,得到片元的颜色,不在则给一点环境光
但是这样会导致一个边缘过度过于生硬的问题,所以解决方案一般是定义一个内圆和外圆,形成过渡效果,内圆强度是1,内圆到外圆之间强度为1-0,外圆之外同理
光线追踪
光照的到物体后反射光没有消失,仍然可以作为一个新的光源,去影响其他物体
模型加载
高级OpenGL
深度测试 Depth testing
深度缓冲(Depth Buffer) 深度缓冲是由窗口系统自动创建的,它会以16、24或32位float的形式储存它的深度值,在大部分的系统中,深度缓冲的精度都是24位的。
深度缓冲中储存每一个(片元)屏幕坐标的深度值,会与相同坐标的片段的深度值比较,以此来确定是否更新深度值 -->也就是确定是否通过深度测试,要不要丢弃当前片段,亦即该片段位于其他片段后面,不能被看见
深度测试是在屏幕空间中运行的,是屏幕空间坐标
你会需要对所有片段都执行深度测试并丢弃相应的片段,但不希望更新深度缓冲。基本上来说,你在使用一个只读的(Read-only)深度缓冲。OpenGL允许我们禁用深度缓冲的写入,只需要设置它的深度掩码(Depth Mask)设置为GL_FALSE就可以了,如在立方体贴图章节有介绍一个使用场景
👍 提示
现在大部分的GPU都提供一个叫做提前深度测试(Early Depth Testing)的硬件特性。提前深度测试允许深度测试在片段着色器之前运行。只要我们清楚一个片段永远不会是可见的(它在其他物体之后),我们就能提前丢弃这个片段。 片段着色器通常开销都是很大的,所以我们应该尽可能避免运行它们。当使用提前深度测试时,片段着色器的一个限制是你不能再写入片段的深度值。如果一个片段着色器对它的深度值进行了写入,提前深度测试是不可能的。OpenGL不能提前知道深度值。
- 深度精度:
远处和近处的对于深度值得精度需求不一致,越近的地方,需要的精度越高
重要的是要记住深度缓冲中的值在屏幕空间中不是线性的(在透视矩阵应用之前在观察空间中是线性的)
也就是说,在应用投影矩阵后,会把深度值做一个非线性变换
- 深度冲突
两个面非常近的时候,深度缓冲没有足够的精度来区分两个面的前后关系,会导致其不断的切换前后顺序,产生闪烁效果
解决方法:
- 不要把面离得太近,设置不可观察的小距离
- 把近平面设置的尽量远一点(不影响效果(物体被裁切掉)的前提下),深度缓冲的非线性原理,物体靠近近平面时精度更高。
- 提高深度缓冲的精度(默认24位,可以提高到32位,但是影响性能)
- 总结关于深度测试的内容
模板测试 Stencil Test
和深度测试一样,模板测试也是用来控制像素是否允许写入的一个方式。
来自kimi的通俗解释
✏️ 提示
OpenGL是一个用于渲染2D和3D图形的跨语言、跨平台的应用程序编程接口(API)。在OpenGL中,模板测试(Stencil Test)是一种可选的图形渲染阶段,它允许开发者控制像素是否被写入帧缓冲区(framebuffer)。 通俗来说,模板测试可以想象成一个“模板”,它定义了哪些像素是“允许”被渲染的,哪些是“不允许”的。这在进行复杂的图形效果,比如阴影、反射、轮廓线等时非常有用。 模板测试的工作原理如下:
- 模板缓冲区(Stencil Buffer):这是帧缓冲区的一部分,用于存储模板测试的结果。每个像素都有一个与之对应的模板值。
- 模板函数(Stencil Function):这是一个函数,用于比较当前像素的模板值和预设的参考值。常见的比较函数包括等于、不等于、小于等。
- 模板操作(Stencil Operation):如果模板函数的比较结果为真(即满足条件),则执行的操作。常见的操作包括保持当前模板值、替换为新的模板值、将模板值设置为0等。
- 应用模板测试:在渲染过程中,OpenGL会根据模板测试的结果决定是否将像素写入帧缓冲区。如果模板测试未通过,像素将被丢弃,不会显示在屏幕上。 举个例子,假设你想要渲染一个复杂的场景,其中包含多个透明物体。如果不使用模板测试,这些透明物体可能会相互覆盖,导致渲染效果不理想。通过使用模板测试,你可以先渲染一个物体,然后设置模板测试,使得只有那些未被先前物体覆盖的像素才能被后续物体渲染,这样就可以避免物体之间的相互覆盖。 模板测试是OpenGL中一个非常强大的工具,它提供了高度的灵活性和控制力,使得开发者能够创造出各种复杂的视觉效果。
混合 Blending
OpenGL中,混合(Blending)通常是实现物体透明度(Transparency)的一种技术。透明就是说一个物体(或者其中的一部分)不是纯色(Solid Color)的,它的颜色是物体本身的颜色和它背后其它物体的颜色的不同强度结合。
混合发生在片段着色器以及所有的测试通过之后,按照透明度来混合当前片段输出的颜色与颜色缓冲中(绘制前一个物体的片段输出)的颜色值,更新到颜色缓冲中去
普通混合是绘制次序相关的,距离相机远的物体如果后面绘制,因为深度测试不通过,所以会影响显示的效果。一个解决的方式是绘制前先对物体排序,但是会带来另一个问题,还需要考虑旋转缩放等变换,特殊形状以及增加性能消耗等,
解决方案是 更高级的技术还有次序无关透明度(Order Independent Transparency, OIT) 参考英文版的第八章:Guest Articles——2020——OIT
面剔除 Face Culling
OpenGL能够检查所有面向(Front Facing)观察者的面,并渲染它们,而丢弃那些背向(Back Facing)的面
是指:一个封闭图形的前后两个面
原理:
每组组成三角形图元的三个顶点就包含了一个环绕顺序。OpenGL在渲染图元的时候将使用这个信息来决定一个三角形是一个正向三角形还是背向三角形。默认情况下,逆时针顶点所定义的三角形将会被处理为正向三角形
实际上就是法线方向的面是正面
当你定义顶点顺序的时候,你应该想象对应的三角形是面向你的,所以你定义的三角形从正面看去应该是逆时针的。这样定义顶点很棒的一点是,实际的环绕顺序是在光栅化阶段进行的,也就是顶点着色器运行之后。这些顶点就是从观察者视角所见的了。
观察者所面向的所有三角形顶点就是我们所指定的正确环绕顺序了,而立方体另一面的三角形顶点则是以相反的环绕顺序所渲染的。这样的结果就是,我们所面向的三角形将会是正向三角形,而背面的三角形则是背向三角形
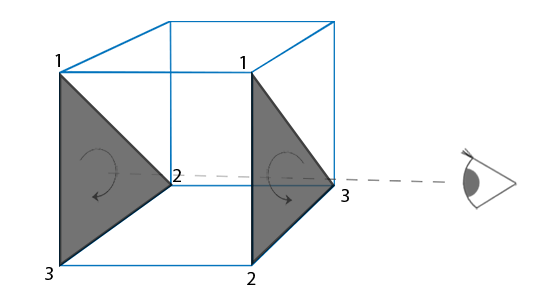
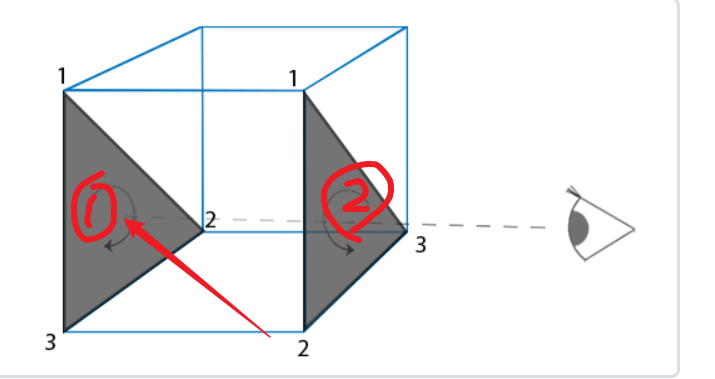
在顶点数据中,我们将两个三角形都以逆时针顺序定义(正面的三角形是1、2、3,背面的三角形也是1、2、3(如果我们从正面看这个三角形的话))。然而,如果从观察者当前视角使用1、2、3的顺序来绘制的话,从观察者的方向来看,背面的三角形将会是以顺时针顺序渲染的。虽然背面的三角形是以逆时针定义的,它现在是以顺时针顺序渲染的了。这正是我们想要剔除(Cull,丢弃)的不可见面了!
📌 提示
这个地方真的不好理解,这个面剔除居然是和threejs中的双面材质是同一回事,困扰了我非常长的时间!!! 以下是我的理解:
- 为什么开启面剔除(默认开启,渲染front-face)了,进入模型内,就不能显示面了呢? 答: 因为进入模型内,看到的哪个面,就是【背面】了,是会被剔除的,如下图当进入模型内部时能看到【面1】,说明【面2】才是正面,所以这个时候【面1】是会被剔除的!
- 而不是【面1】的正反面,【面1】没有正反面之分
- OpenGL逆时针绘制时,并不会区分正反面,但是观察的视角不同,会影响绘制的顶点的顺序
- 旋转后,面的前后也就反过来了,所以另一面又被剔除了,也就是只能从外部看到模型的mesh和材质,从而看起来就是单面材质了
帧缓冲 Framebuffer
用于写入颜色值的颜色缓冲、用于写入深度信息的深度缓冲和允许我们根据一些条件丢弃特定片段的模板缓冲。这些缓冲结合起来叫做帧缓冲(Framebuffer),它被储存在GPU内存中的某处
这个概念还是很重要的,它是实现后处理的关键技术,允许在渲染过程通过不同的步骤加入不同的效果
threejs中的WebGLRenderTarget是一个帧缓冲,所以有时间要去看一下这里的源码实现和关联
就是帧缓冲,用来实现离屏渲染和后期处理
立方体贴图 Cubemaps
立方体贴图
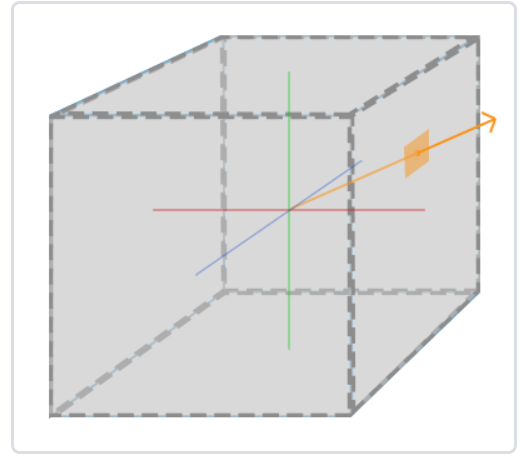
立方体贴图就是一个包含了6个2D纹理的纹理,每个2D纹理都组成了立方体的一个面:一个有纹理的立方体。你可能会奇怪,这样一个立方体有什么用途呢?为什么要把6张纹理合并到一张纹理中,而不是直接使用6个单独的纹理呢?立方体贴图有一个非常有用的特性,它可以通过一个方向向量来进行索引/采样。假设我们有一个1x1x1的单位立方体,方向向量的原点位于它的中心
📌 提示
方向向量的大小并不重要,只要提供了方向,OpenGL就会获取方向向量(最终)所击中的纹素,并返回对应的采样纹理值。
天空盒 Skybox
📚 提示
天空盒实现原理: 利用立方体贴图的采样只需要一个方向向量即可,创建一个小的1x1x1的立方体,然后使用其顶点作为采样的方向向量去对立方体贴图采样,这样即可得到一个所有方向的像素 然后在场景中第一个绘制立方体贴图,并且在绘制立方体贴图的时候关闭深度缓冲写入,这样既能通过了深度测试,又不影响深度缓冲里的值。然后再绘制其他物体,就能保证立方体贴图一直都在所有物体的后面了 但是可以优化,因为背景绘制的时候多跑了一些前面物体遮挡的坐标的立方体贴图片段着色器,浪费性能 改进:
- 最后绘制立方体贴图(它只是一个1x1x1的立方体,意味着距离摄像机的距离也只有1,所以需要后面的步骤,欺骗深度缓冲,让它认为天空盒有着最大的深度值1.0)
- 立方体贴图的顶点gl_Position的坐标位置修改,把z值设置为w相等的值
- 把深度测试函数设置成GL_LEQUAL (即需要保证天空盒在深度值小于或等于深度缓冲时通过深度测试,而不仅是小于) 改进的原理:1. 透视除法是在顶点着色器后执行,会将xyz都除以w分量,然后又从深度测试得知,z分量等于顶点的深度,也就是通过这样的设置后,执行透视除法后z的值会一直等于1(w/w = 1) 尽管如此,threejs中还是先绘制了cubeMap,并关闭了深度测试和深度写入来实现的,同时也设置了w分量与Z分量相等,即深度一直都是1, AI的说法是,即使最后绘制cubemap能节约一定的性能,但是开启了深度测试和深度缓冲也会增加一定的性能消耗,实际可能会相互抵消,以及可能会导致的物体顺序的错误问题(想不明白,应该不会)
环境映射
使用环境立方体贴图的技术叫做环境映射(Environment Mapping),其中最流行的两个是反射(Reflection)和折射(Refraction)
需要考虑物体的折射计算和反射计算
高级数据
讲内存和缓冲的,略过
高级GLSL
介绍一些GLSL的内建变量(built-in variable),有需要可以去看看
几何着色器
暂时略过,较少使用
实例化 Instancing
绘制大量相同顶点,但有不同世界位移的物体时(模型实例)
实例化: 将数据一次性发送给GPU,然后使用一个绘制函数让OpenGL利用这些数据绘制多个物体
📌 提示
与**
绘制顶点本身**相比,使用glDrawArrays或glDrawElements函数告诉GPU去绘制你的顶点数据会消耗更多的性能,因为OpenGL在绘制顶点数据之前需要做很多准备工作(比如告诉GPU该从哪个缓冲读取数据,从哪寻找顶点属性,而且这些都是在相对缓慢的CPU到GPU总线(CPU to GPU Bus)上进行的)。所以,即便渲染顶点非常快,命令GPU去渲染却未必。
原理就是减少Drawcall,以缩短GPU与CPU之间的通信时间,从而达到性能优化的目的,影响性能的不只是内存占用量,还有通信时间等
一个渲染调用来绘制多个物体,来节省每次绘制物体时CPU -> GPU的通信
抗锯齿 Anti Aliasing
锯齿: 能够清楚看见形成边缘的像素,是边缘像素采样的原因,包含某个片段或者舍弃某个片段
抗锯齿的的原理,
SSAA 超采样抗锯齿(Super Sample Anti-aliasing) 使用更高的分辨率(即超采样)来渲染场景,当图像输出在帧缓冲中更新时,分辨率会被下采样(Downsample)至正常的分辨率,但是额外的分辨率需要更多的片段着色器,有性能问题
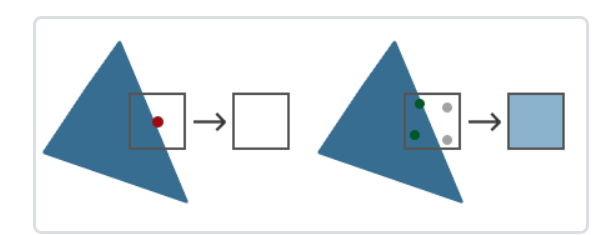
MSAA 多重采样抗锯齿(Multisample Anti-aliasing) 每个像素分成多个子采样点,像素点最终颜色按照三角形覆盖了多少个子采样点的比例来决定,这样片段着色器数量不变,但是边缘更加圆滑
有硬件结构来支持,性能会好一些
高级光照
高级光照
冯氏光照模型计算镜面反射存在的问题:
- 当镜面光的反射光线与观察方向之间的夹角大于90度时,计算得到的镜面光照分量为0
- 这与物理规律不符,即使大于90度我们仍然能够看到反射的光,尽管它可能不如直接反射到观察者眼中的光那么强烈。这是因为光线在表面上的反射并不完全遵循一个严格的几何模型,而是有一定的扩散。
- 光的散射:即使在理想情况下,光线在表面上的反射也会因为表面微小的不规则性而发生散射。这意味着即使在接近90度的视角,也会有一些光线散射到观察者的眼睛中。
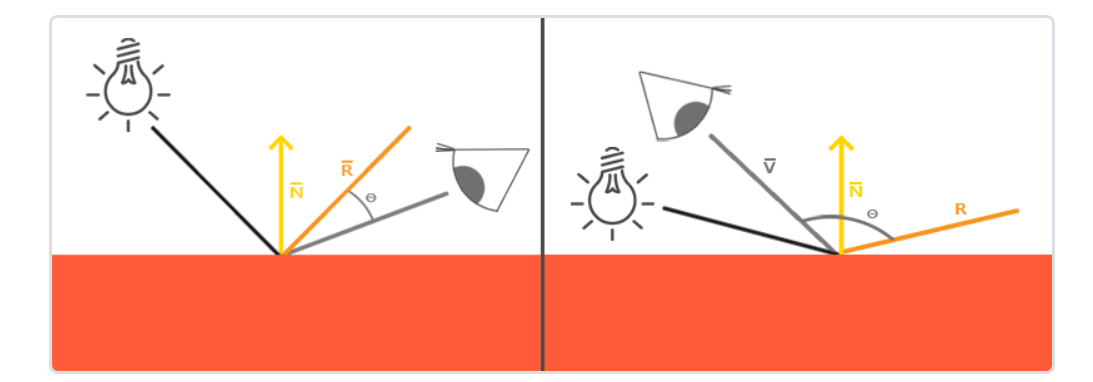
Blinn-Phong 模型是对冯氏光照的一个改进,它不再使用反射光线与观察方向的夹角计算镜面分量,而是引入一个半程向量(Halfway Vector),使用半程向量与法线的夹角的余弦值作为镜面分量的系数
半程向量可以使用光线向量与观察向量之和标准化而来
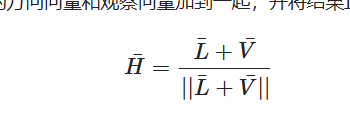
Blinn-Phong着色模型正是早期固定渲染管线时代时OpenGL所采用的光照模型
冯氏模型与Blinn-Phong模型也有一些细微的差别:半程向量与表面法线的夹角通常会小于观察与反射向量的夹角。所以,如果你想获得和冯氏着色类似的效果,就必须在使用Blinn-Phong模型时将镜面反光度设置更高一点。通常我们会选择冯氏着色时反光度分量的2到4倍
解释:
cos值在0-90度之间是单调递减的,但是计算镜面因子是计算的次方,而点乘的结果小于1,所以 Blinn-Phong的因子更大一些,需要的次数就更高,如下图
float spec = pow(max(dot(normal, halfwayDir), 0.0), shininess);
vec3 specular = lightColor * spec;
Gamma校正 Gamma Correction
📌 提示
目前仅理解了gamma矫正的原因和概念,应用需要后续再去理解
根本原因:人眼对光线的亮度感知与实际的物理亮度存在差异,需要进行转换
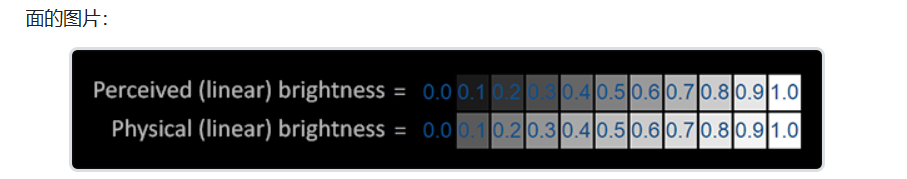
我的理解:
所有的颜色值,经过显示显示时,都会做一个gamma变换(也就是做2.2次幂运算),把颜色调暗到人眼感知亮度
OpenGL计算的颜色值可以认为是物理亮度,输出到显示器时也会做一个显示器gamma变换,所以需要一个gamma矫正(做1/2.2次幂运算),抵消掉显示器gamma的影响
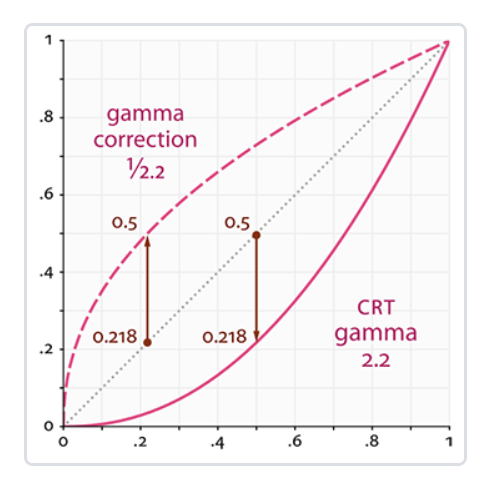
红色实线时显示器gamma,这个是显示器自动进行的操作,红色虚线是gamma矫正曲线
硬盘储存的图片是经过gamma矫正的,也就是做了一个(1/2.2次幂运算,2.2或者其他gamma值),所以实际会更亮
注意点:
- diffuse贴图需要使用sRBG纹理
- specular、法线贴图不能使用sRGB纹理,会破坏光照
- 光照的衰减方程 (后续再深入理解一遍)
阴影
阴影是光线被阻挡的结果
阴影映射 Shadow Mapping
阴影映射(Shadow Mapping)背后的思路非常简单:我们以光的位置为视角进行渲染,我们能看到的东西都将被点亮,看不见的一定是在阴影之中了
点阴影
CSM
法线贴图
法线贴图
作用: 让每个片段(fragment)都能有自己单独的法线
使用使用一个2D纹理来储存法线数据,使用采样的方式来获取每个fragment的法线数据,这样的贴图称为法线贴图
注意点1:因为法线的方向几乎都是偏向Z轴(意味着b数值大一点),所以图片会呈现一个蓝色调 ,朝向x会偏红,朝向y轴会偏绿
**注意点2:**法线数值取值范围是[-1,1],rgb颜色范围[0,1],所以存储和读取的时候都要经过一个转换,
读取时,从 [0,1] 法线向量转换为范围[-1,1] normal *2-1
储存时,从 [-1,1] 转换至 [0,1] normal/2+0.5
缺点:
法线贴图出现的问题: 默认基于贴图面法线方向是的Z轴正方向,存储的法线的值(储存的是固定的值,读取也是固定的值),如果贴图贴到物体上的贴图的方向旋转了,也就是贴图面的法线(不再朝向正Z轴),这时采样得到的法线方向就会出错(仍然是指向正Z面的值)
这时候就需要使用切线空间来解决这个问题。
切线空间:
📌 提示
相当于把法线定义在一个局部的空间中,在这个空间中的贴图面永远朝向Z轴正方向
使用贴图的与贴图面固定为Z轴方向得到的一个矩阵,两个方案:
- 把矩阵传给片段着色器,再把采样得到的法向量转换到世界空间,来计算光照(简单直观)
- 把光照的的坐标转换进去,减少片段着色器使用矩阵变换,(性能优化)
视差贴图
HDR (High Dynamic Range, 高动态范围)
可以允许光线强度暂时大于1,然后把它转换回[0,1]的范围内,也就是说能利用更大范围的的颜色值从而能获取更大范围的场景细节
泛光
延迟着色法
思路是把前面的顶点着色器的输出信息全部存储到一系列的G-buffer上,然后再统一进行光照,这样可以避免运行一些深度测试不通过的片段,以达到提升性能的效果【是否和提前深度测试 带来的性能优化相当,未找到答案】
SSAO
PBR
全称(physically based rendering),基于物理的渲染
理论
基础介绍
- 基于能量守恒定律
- 基于微平面的表面模型
- 应用基于物理的BRDF (双向反射分布函数 bidirectional reflectance distribution function)
微平面模型:
在微观视角下,所有平面都是粗糙的,使用一个统计学的方法来估计表面的粗糙程度
一些概念:
- 辐射通量:辐射通量Φ表示的是一个光源所输出的能量
- 立体角: 投射到这个单位球体上的截面的面积就被称为立体角(Solid Angle),可以理解为一个带有体积的方向
- 辐射强度:辐射强度(Radiant Intensity)表示的是在单位球面上,一个光源向每单位立体角所投送的辐射通量,计算方式,辐射通量除以立体角ω
- 辐照度: 所有投射到点p上的光线的总和
- 辐射率: 表示一个区域平面上光线总量的物理量,受到入射(Incident)(或者来射)光线与平面法线间的夹角θ的余弦值cosθ的影响
光照
IBL
漫反射辐照
镜面IBL
渲染优化建议
由上章的分析,可以很容易给出渲染优化建议:
减少CPU和GPU的数据交换:
合批(Batch)
减少顶点数、三角形数
视锥裁剪
- BVH
- Portal
- BSP
- OSP
避免每帧提交Buffer数据
- CPU版的粒子、动画会每帧修改、提交数据,可移至GPU端。
减少渲染状态设置和查询
- 例如:
glGetUniformLocation会从GPU内存查询状态,耗费很多时间周期。 - 避免每帧设置、查询渲染状态,可在初始化时缓存状态。
- 例如:
启用GPU Instance
开启LOD
避免从显存读数据
减少过绘制:
避免Tex Kill操作
避免Alpha Test
避免Alpha Blend
开启深度测试
- Early-Z
- 层次Z缓冲(Hierarchical Z-Buffering,HZB)
开启裁剪:
- 背面裁剪
- 遮挡裁剪
- 视口裁剪
- 剪切矩形(scissor rectangle)
控制物体数量
- 粒子数量多且面积小,由于像素块机制,会加剧过绘制情况
- 植物、沙石、毛发等也如此
Shader优化:
- 避免if、switch分支语句
- 避免
for循环语句,特别是循环次数可变的 - 减少纹理采样次数
- 禁用
clip或discard操作 - 减少复杂数学函数调用
更多优化技巧可阅读: